


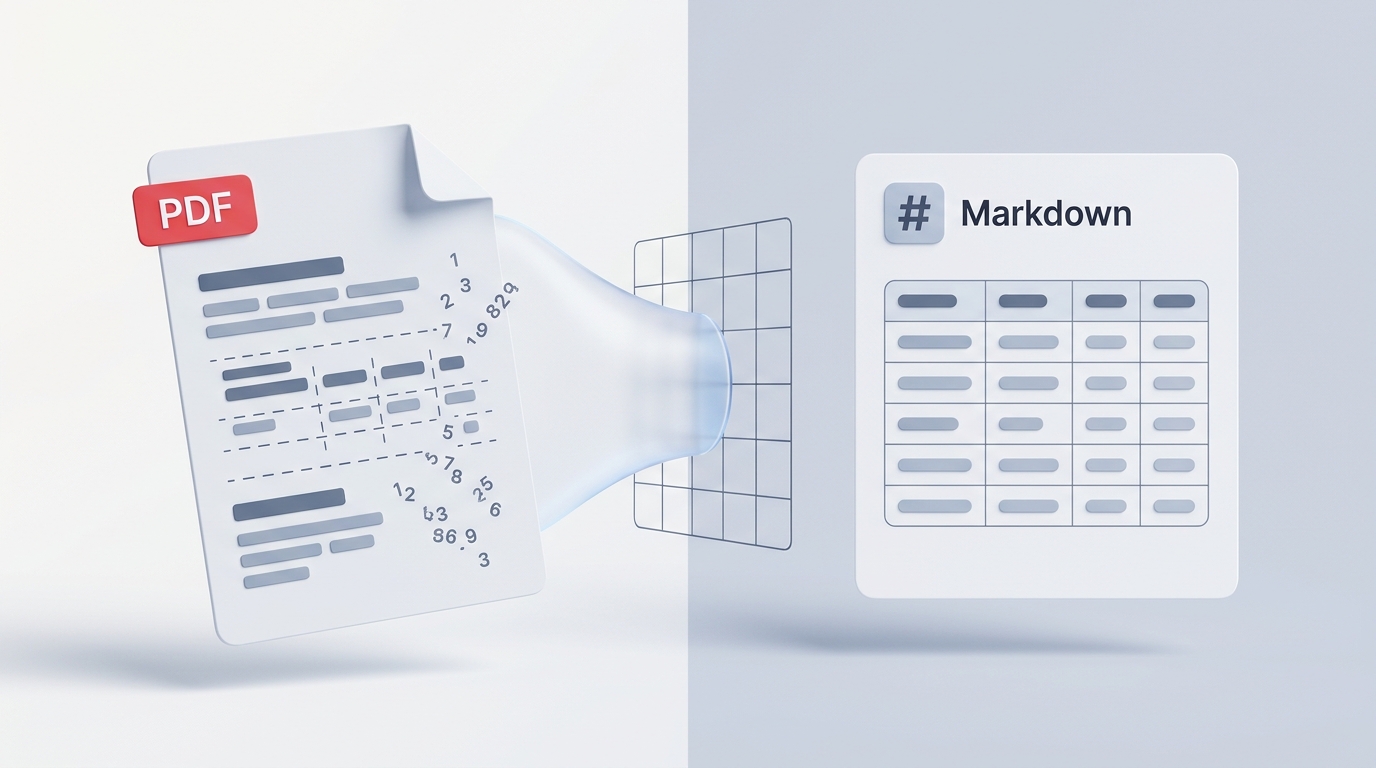
几乎所有日常跟电子文档打交道的人,都曾遭遇过“复制粘贴灾难”。
当你打开一份 PDF 行业研报、学术论文或公司财报,选中了三段核心内容以及一张工整的财务表格,按下 Ctrl+C 并粘贴到 Microsoft Word、Notion 或邮件正文中时——
迎接你的往往不是整齐的段落,而是一场排版车祸:
- 每一行末尾都被强行插入了硬回车,流畅的句子被切成一段段断续的碎词;
- 多栏排版的论文或研报被横向串行读取,左右两栏截然不同的内容揉杂在一起,彻底沦为天书;
- 原本整理顺的财务表格彻底解体——数值脱离了表头,变成一堆错位乱散的孤立数字;
- 如果你把这团乱麻直接喂给 ChatGPT、Claude 或 DeepSeek 等 AI 助手,模型甚至会大面积“胡说八道”或曲解核心指标,因为底层的上下文结构早已支离破碎。
为什么像“复制粘贴文字”这么基础的操作,在 PDF 上会如此频繁地翻车?更重要的是,我们该如何快速提取出干净、规整的文字和表格,而无需花费数小时手动删回车、补空格、重画表格边框?
深入了解 PDF 底层的二维坐标渲染机制,不仅能让你明白普通剪贴板为何频频失效,也能帮你找到利用结构化提取彻底破局的高效方案。
为什么从 PDF 复制文本总让人抓狂?
要彻底解决文本提取的痛点,首先得理解 PDF 为何会表现得如此“死板”。
当你在网页或 Word 文档中复制文字时,计算机能够清晰理解其语义结构:它知道段落从哪里开始、哪一行是标题、表格单元格的边界在哪里。
然而,PDF 早在三十年前被发明时,其核心使命是为了取代纸张与激光打印机。在 PDF 的底层世界里,根本不存在连贯的“段落”或“表格”概念,它只存储二维画布上的视觉坐标点。对 PDF 而言,一句话本质上只是一组绘制在特定毫米偏移位置上的字形轮廓(例如:“在坐标 x=45, y=120 处绘制字母‘T’”)。
由于 PDF 文件本身缺乏“句子”或“表格行/列”的语义认知,系统的默认复制工具只能粗暴地按照字形在视觉网格上的排列顺序去抓取字符。
这就导致了三个令人头疼的经典顽疾:
1. 双栏/多栏串行读取
在包含双栏或三栏排版的学术论文、券商研报中,人类的正常阅读顺序是读完第一栏再读第二栏。然而常规的复制命令却是横跨页面水平扫描的:它会先抓取 A 栏第 1 行、接着抓取 B 栏第 1 行,再抓取 A 栏第 2 行……最终复制出来的文字错乱不堪、不知所云。
2. 表格数据完全解体
表格是一种二维关系网格。但当你直接从 PDF 复制表格并粘贴到 Excel 或文字处理软件中时,隐形的网格边界瞬间瓦解。所有数字与它们对应的日期、币种和分类表头彻底脱节。原本标注在“第三季度运营成本”下方的数值 ¥142,000 沦为了孤零零的浮动数字,让你只能对着一堆数据盲目猜测归属。
3. 大模型“幻觉”陷阱
如今很多分析师、科研人员和学生习惯将 PDF 摘录喂给 ChatGPT、Claude 或本地大模型进行摘要总结与数据问答。当你给大模型输入一段缺少表格结构、语句被频繁腰斩的混乱语料时,模型无法建立正确的语义关联,往往会“脑补”出看似合理实则完全错误的数据,导致输出不可靠的分析结论。
破局方案:将 PDF 转化为结构化 Markdown
要从固化死板的 PDF 中拯救文本与数据,最优雅且高效的途径并非直接提取纯文本,而是将其转换为结构化 Markdown。
Markdown 是一种轻量、干净且人类完全可读的通用排版语言,也是 Notion、Obsidian、Slack、飞书和 GitHub 等现代生产力工具的共通标准。它通过极其简洁的通用符号构建文档结构:
- 使用
#和##标明标题,严格保留文档的层次大纲; - 列表项目与编号保持井然有序,杜绝断行乱码;
- 表格采用清晰的管道符语法(
| 表头 A | 表头 B |),牢牢锁定行与列的精准对齐。
一旦文本被提取为干净的 Markdown 格式,你就可以直接将其无缝粘贴到 Word、飞书文档、Notion 或 AI 提示词中,彻底告别碎回车与版面坍塌。
极简实操:将二维坐标智能重构为 Markdown
你无需在电脑上配置复杂的 Python 环境、不用敲难懂的命令行,更不用购买昂贵的企业级软件。直接使用我们的浏览器端 PDF 转 Markdown 工具,即可在本地设备上瞬间完成提取。
[ 排版复杂的双栏/多栏 PDF ]
            │
            ▼ (直接拖拽导入)
[ 本地空间几何分析引擎 ] ──► 重构连贯段落、自动识别表格网格
            │
            ▼ (毫秒级即时呈现)
[ 结构工整的 Markdown 文本 ] ──► 一键粘贴至 Notion、Word、Excel 或大模型
1. 本地安全载入复杂文档
在浏览器中打开 PDF 转 Markdown 工具,将你的 PDF 文件直接拖放至工作区。由于提取引擎基于 WebAssembly 完全在本地浏览器内存中运行,你的文件绝不会上传至任何云端服务器。即便是提取银行对账单、公司核心未公开财报等机密材料,敏感数据也始终安全留存在你自己的电脑里。
2. 空间布局算法与表格智能解析
与机械性水平扫描字符的传统工具不同,我们的本地引擎会对字符的空间几何关系进行智能聚类分析:
- 多栏自动重构:精准识别双栏或多栏文本块,严格按照各栏垂直阅读动线顺序抓取,彻底消除左右串行;
- 表格智能还原:识别数据行的坐标对齐线与单元格留白,将散落的数字网格自动重建为标准的 Markdown 管道表格;
- 清理碎断行:自动剔除行末的人为强制换行符,同时准确保留真实的自然段落分隔。
3. 一键复制或导出文件
几秒钟之内,转换好的标准 Markdown 文本就会呈现在屏幕上。你可以直接点击 复制到剪贴板,粘贴到你的笔记软件或表格中;也可以点击下载格式化的 .md 文件,永久保存在本地知识库中。
方案横向对比:哪种提取方式更胜一筹?
根据你的实际使用需求,以下是几种常见文本提取方式的实测对比:
| 关键特性与能力 | 普通复制粘贴 (Ctrl+C) | 常规云端 OCR 转换网站 | VersaPDF 浏览器纯本地转换 |
|---|---|---|---|
| 段落连贯度 | 到处充斥硬回车,断句破碎 | 效果参差不齐,断行不稳定 | 段落完整连贯,无多余断行 |
| 表格保留能力 | 结构彻底瓦解,沦为散落文本 | 列对齐容易错位偏移 | 完整还原为标准管道表格 (| 表头A | 表头B |) |
| 多栏处理能力 | 左右横向串行,语句杂乱 | 识别结果往往不稳定 | 严格遵循纵向栏目自然阅读动线 |
| 数据隐私安全 | 高(仅在本机剪贴板) | 低(原始文件必须上传至云端服务器) | 极高(100% 浏览器本地沙箱处理,零上传) |
| 下游软件兼容性 | 仅限普通纯文本 | 样式各异,不易二次编辑 | 无缝兼容 Notion、Word、Excel 及大模型 |
高阶技巧:处理复杂大型报告的实用组合拳
1. 从巨幅报告中精准提取目标页
如果你面对的是一份长达 200 页的上市公司年报,而你只需要第 45 页中的三张核心表格,完全没必要把整份大文件全部丢进去解析。
你可以先使用我们的 提取页面工具,把包含所需数据的特定页面单独拆出。接着将这份精简的小文件拖入 PDF 转 Markdown 工具 中,不到 10 秒就能搞定精准表格提取。
2. 闭环工作流:将 Markdown 重新输出为精美 PDF
当你利用提取出来的 Markdown 内容在 Obsidian、Notion 或 VS Code 中写完了分析摘要、撰写好了调研报告后,最终往往还需要将其排版为正式文档交付给客户或领导。
与其在简陋的打印设置里反复调试边距,不如使用我们的 Markdown 转 PDF 工具,一键将排版工整的 Markdown 笔记转化为版式优美、矢量高清的交付级 PDF 文档。
结语:让文档数据重获新生
别再把大把宝贵时间浪费在手动删回车、反复对齐空格和重打表格上了。PDF 虽然诞生于 20 世纪 90 年代的打印机时代,但借助现代浏览器端的空间几何解析技术,你完全可以在数秒之内将锁死在版面里的数据解放出来,转化为干净规整、随时可用的结构化语料。