


PDF a Markdown
Herramienta profesional para convertir PDF a Markdown en el navegador. Análisis tipográfico heurístico, detección de títulos H1/H2/H3, listas y código monoespaciado. 100% privado en entorno local, sin límites ni registros.
Selecciona tus archivos o arrástralos aquí
Compatible con PDF · Extracción estructurada de texto y jerarquía tipográfica · Sin límites de tamaño · 100% privado en el navegador
Cómo usar PDF a Markdown gratis online
Rápido, seguro y completamente del lado del cliente. Sin colas de subida, sin límites de tamaño y sin transferir datos fuera de su equipo.
Selecciona tu documento PDF o arrástralo directamente al área de trabajo.
El sistema lee el contenido y organiza títulos, listas y texto en formato Markdown limpio.
Alterna entre el código fuente Markdown y la vista maquetada, configurando saltos o líneas.
Haz clic en Copiar Markdown para pegarlo donde necesites o pulsa Descargar para guardar el archivo .md.
Arrastra un documento PDF aquí o pulsa para elegir
Extracción estructurada en Markdown · 100% local en tu navegador
Especificacion_Proyecto.pdf
1.8 MB · 8 Páginas
Preguntas frecuentes
¿El texto Markdown generado es adecuado para utilizar como contexto en modelos de IA (ChatGPT, Claude, DeepSeek)?
Es idóneo. Al alimentar modelos de lenguaje con Markdown estructurado en lugar de texto plano sin formato copiado de un visor PDF convencional, se eliminan saltos de línea artificiales, espaciados erráticos y artefactos visuales. Esto proporciona un contexto semántico claro, reduce el consumo de tokens y mejora la precisión de las respuestas del modelo.
¿El contenido extraído es compatible con aplicaciones como Notion, Obsidian o Logseq?
Totalmente compatible. El motor genera texto conforme al estándar CommonMark. Puedes copiar y pegar directamente el texto en Notion, Bear, GitHub o Joplin, o bien descargar el archivo .md e incorporarlo de inmediato a tu bóveda (vault) de Obsidian o Logseq conservando niveles de títulos y listas.
¿Cómo se procesan las tablas, gráficos e imágenes del documento PDF?
El texto de tablas se extrae de forma secuencial y limpia según sus coordenadas horizontales, mientras que listas y párrafos se estructuran en Markdown estándar. Los elementos puramente gráficos, como imágenes de mapa de bits o fondos decorativos, se omiten para garantizar un resultado de texto limpio, liviano y enfocado en la lectura y consulta.
¿Por qué esta herramienta ofrece mejor resultado que copiar texto directamente desde un visor de PDF?
Los visores convencionales copian el texto siguiendo el orden de dibujo del lienzo gráfico, lo que suele fracturar oraciones en fragmentos inconexos y despoja a los títulos de toda jerarquía semántica. VersaPDF analiza la distribución de fuentes tipográficas para clasificar encabezados (#, ##, ###) y aplica heurísticas para unir líneas cortadas de un mismo párrafo.
¿Mis documentos o datos confidenciales se envían a servidores externos?
No. VersaPDF funciona bajo una estricta arquitectura local en el navegador (Local-First). Toda la extracción de glifos, ordenamiento de coordenadas y generación de la sintaxis Markdown se efectúa en la memoria local de tu dispositivo. Ningún dato ni fragmento de texto se transmite por la red.
¿Existe algún límite en cuanto al número de páginas o tamaño del archivo?
No hay restricciones de tamaño ni cuotas diarias. Al no depender de servidores en la nube, el procesamiento aprovecha la capacidad de cómputo de tu equipo, permitiéndote procesar documentos de cualquier extensión de forma gratuita y sin registro.
¿Es posible volver a convertir el archivo Markdown generado en un documento PDF?
Por supuesto. Una vez que hayas editado o enriquecido tus notas en Obsidian, Notion o tu editor preferido, puedes utilizar nuestra herramienta complementaria Markdown a PDF para generar un documento PDF de alta resolución con tipografía editorial.
¿Puedo procesar documentos PDF escaneados o protegidos con contraseña?
Si el archivo cuenta con contraseña de apertura, debes desbloquearlo previamente con nuestra herramienta Desbloquear PDF. Si se trata de un PDF escaneado que solo contiene imágenes de páginas sin texto seleccionable, se requiere un proceso previo de OCR (reconocimiento óptico de caracteres) para generar la capa de texto vectorial que pueda ser extraída.
¿Por qué el contenido Markdown generado aparece vacío o solo con separadores de página?
El PDF importado está compuesto exclusivamente por imágenes escaneadas o mapas de bits rasterizados, careciendo de una capa de texto vectorial digital interpretable por el navegador. Solución: Asegúrate de que el PDF contenga texto seleccionable. Si es un documento escaneado, pásalo primero por un motor de OCR para incrustar la capa de caracteres antes de extraer su estructura en Markdown.
El archivo tiene una contraseña de lectura y no se puede procesar.
Los documentos PDF con cifrado de propietario o usuario impiden que los motores de análisis web lean sus flujos internos de contenido. Solución: Utiliza primero nuestra herramienta local Desbloquear PDF para remover la clave de acceso de forma segura en tu navegador y vuelve a cargar el documento resultante.
El navegador tarda o responde con lentitud al procesar manuales técnicos de cientos de páginas.
Analizar decenas de miles de glifos tipográficos simultáneamente en la memoria del navegador puede generar una carga computacional elevada en equipos con recursos limitados. Solución: Recomendamos utilizar Dividir PDF para extraer únicamente los capítulos o secciones relevantes antes de procesarlos, obteniendo una conversión instantánea y notas más concisas.
Análisis de coordenadas espaciales y reconstrucción de estructura semántica
Agrupación de líneas de base, inferencia de jerarquía tipográfica y formato CommonMark limpio para notas y modelos de IA.
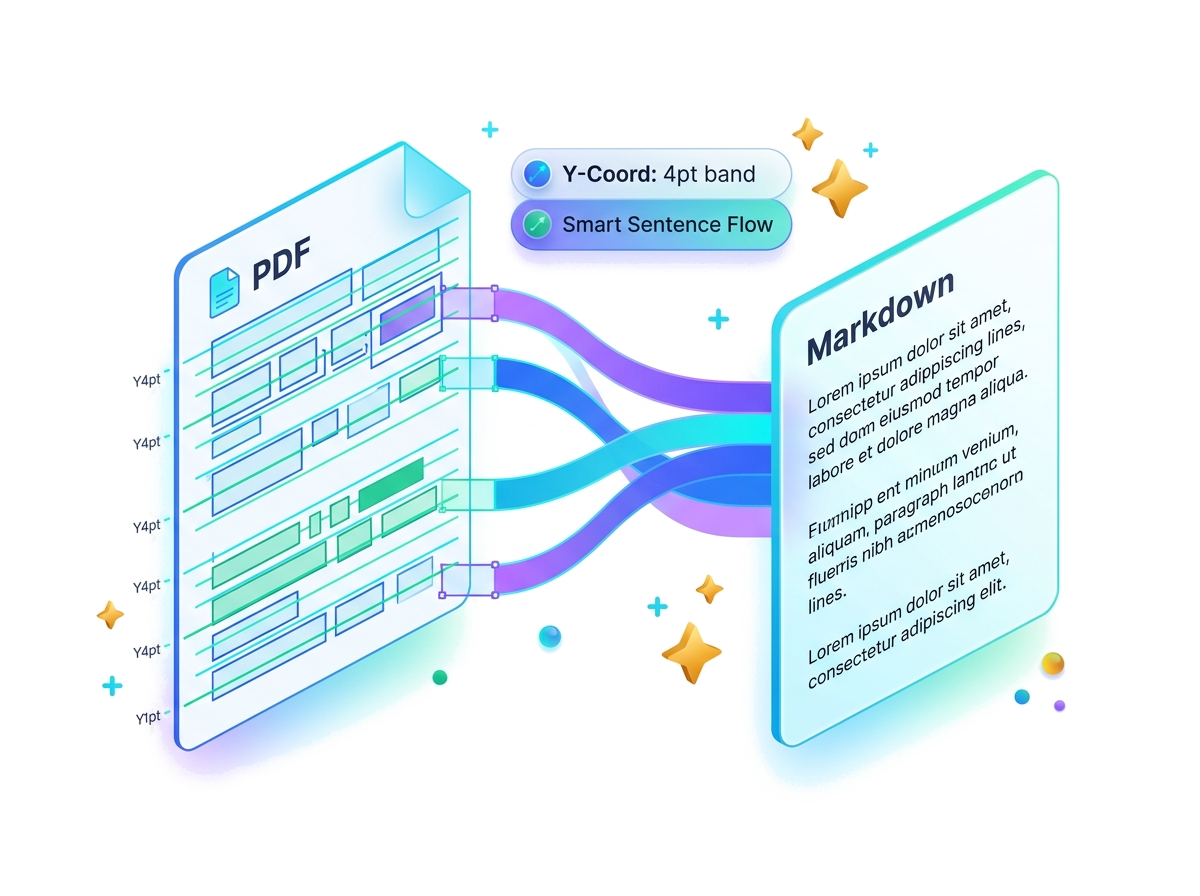
Agrupación de coordenadas de base y flujo continuo de lectura
Extrae matrices de transformación geométrica y coordenadas de base para reconstruir el flujo de lectura natural.
- Agrupación con tolerancia de 4 pt: Agrupa horizontalmente fragmentos de texto en rangos verticales de 4 pt para preservar la cohesión de las líneas.
- Fusión inteligente de párrafos: Detecta saltos de línea suaves y reúne frases divididas en párrafos continuos y legibles.
- Espaciado optimizado para caracteres CJK: Controla con precisión la unión de caracteres chinos, japoneses y coreanos para evitar espacios accidentales.
Jerarquía tipográfica y reconocimiento de patrones
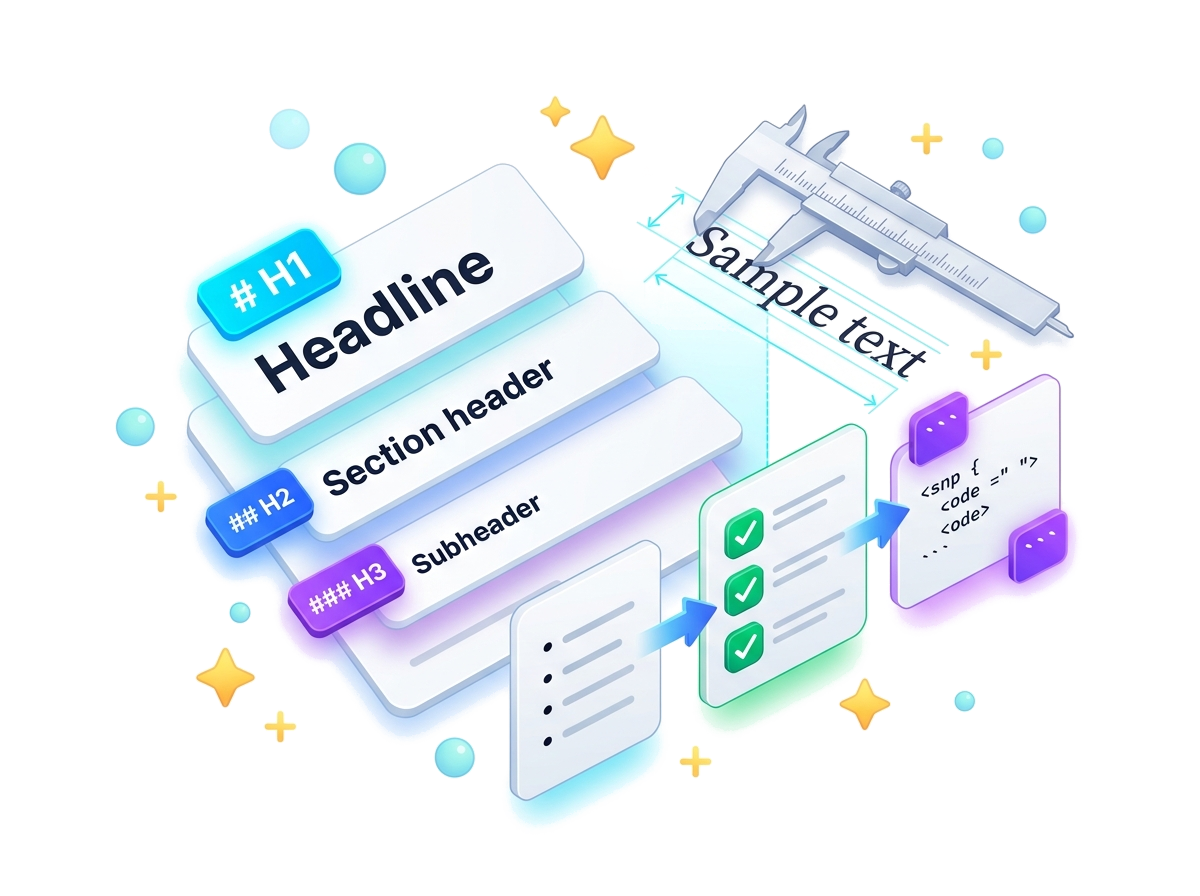
Analiza las frecuencias y dimensiones de fuentes en todo el documento para deducir elementos enriquecidos.
- Inferencia dinámica de encabezados: Compara los tamaños de fuente con el cuerpo del texto para generar títulos # H1, ## H2 y ### H3.
- Reconocimiento de listas: Detecta viñetas (•, -, *) y listas numeradas, transformándolas en sintaxis estándar de Markdown.
- Conservación de bloques de código: Identifica fragmentos en fuentes monoespaciadas (Courier, Consolas) y los envuelve en bloques de código.
Markdown limpio de alta densidad para notas y modelos LLM
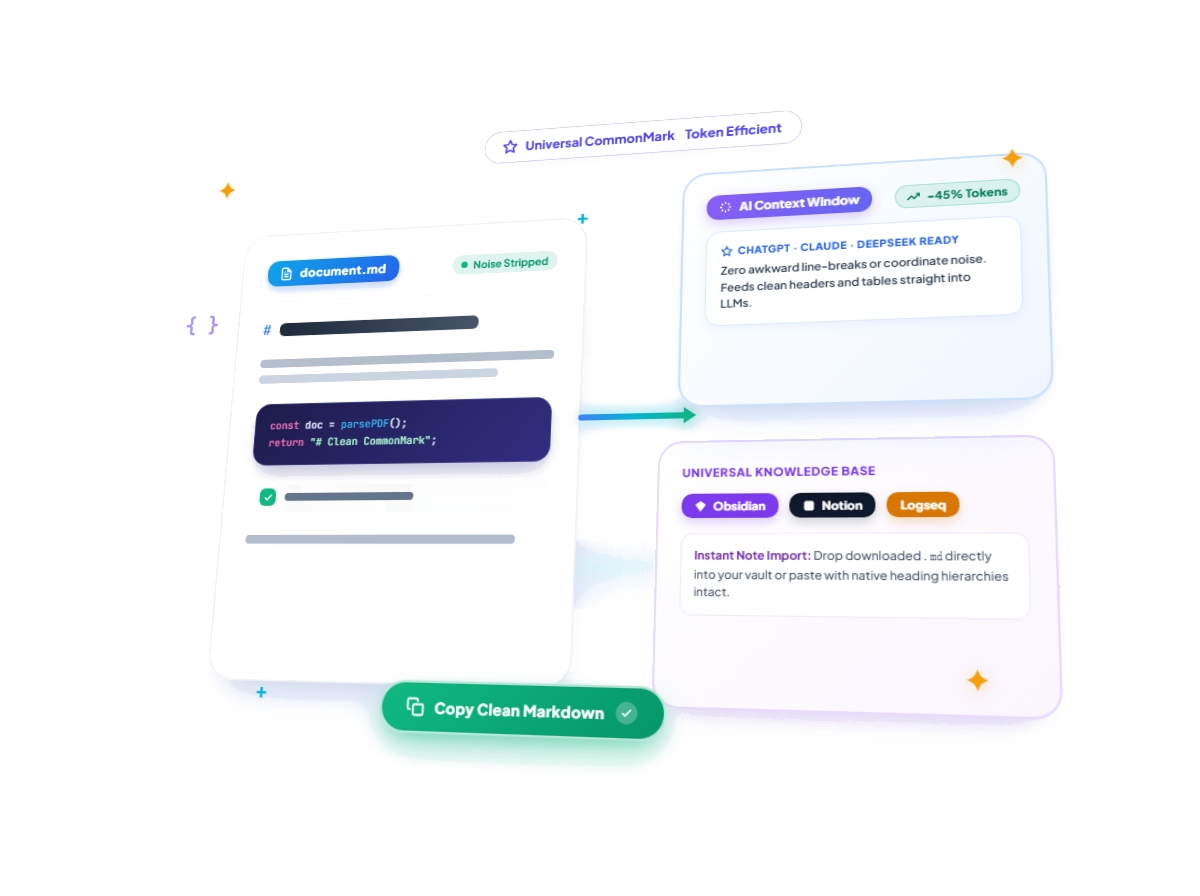
Elimina el ruido visual y las líneas vacías excesivas para proporcionar texto estructurado de máxima fidelidad.
- Ahorro de tokens: Optimiza el texto eliminando cortes artificiales, ideal para alimentar ventanas de contexto de ChatGPT y Claude.
- Estándar CommonMark universal: Genera contenido directamente compatible con Obsidian, Notion, Logseq y editores de Markdown.
- Separadores de página opcionales: Permite alternar divisores de página y etiquetas de comentarios según las necesidades de tu flujo de trabajo.
Privacidad 100% en el navegador para documentos confidenciales
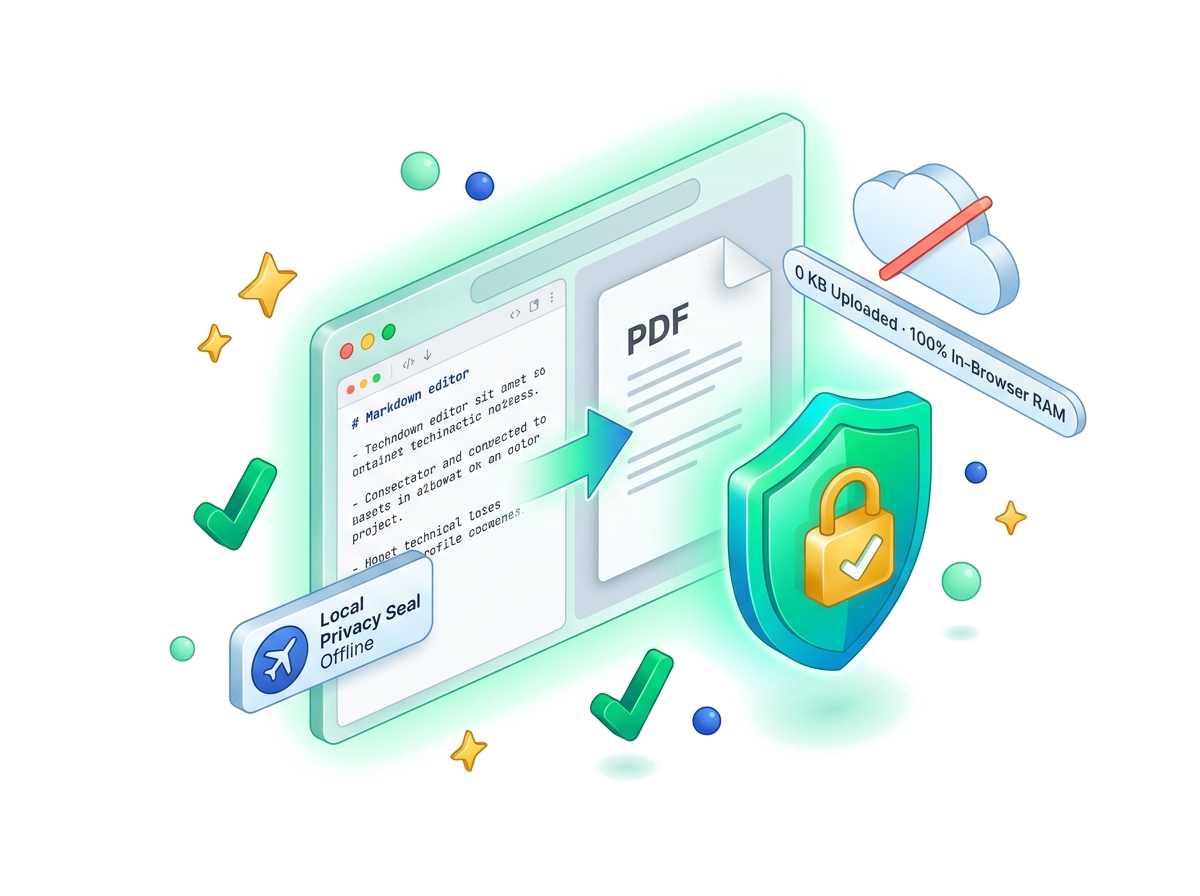
Convierte notas de estudio, borradores de investigación y resúmenes de proyectos sin exponer datos a la nube.
- Ejecución pura en el cliente: Todo el procesamiento se realiza en la memoria del navegador local mediante JavaScript.
- Totalmente operativo sin conexión: Funciona en modo avión o sin acceso a internet, garantizando privacidad absoluta.
- Integración directa en flujos locales: Copia texto limpio o descarga archivos .md para usarlos al instante en tu base de conocimiento.
Herramientas relacionadas
Markdown a PDF
Maqueta y convierte texto Markdown en documentos PDF de alta fidelidad con temas elegantes y vista previa interactiva.
Dividir PDF
Extrae páginas específicas o separa cada página del documento en archivos independientes.
Unir PDF
Combina varios documentos PDF en un único archivo unificado en el orden que elijas.
Desbloquear PDF
Elimina de forma permanente contraseñas de apertura y restricciones de permisos mediante descifrado local.